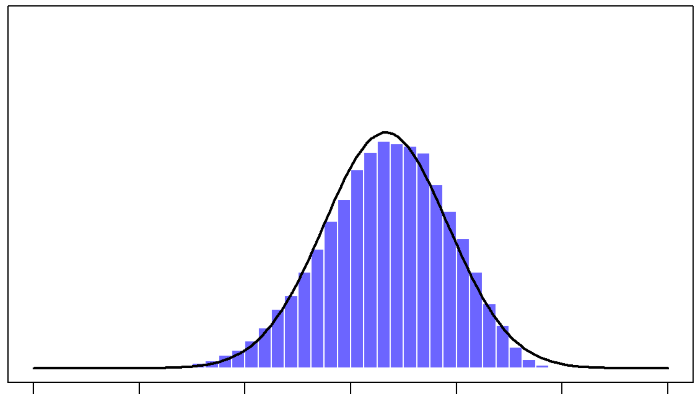
نمونهبرداری از توزیع احتمال به معنی تولید یک تعداد از اعداد به نحوی است که درستنمایی ( Likelihood) آنها توسط تابع توزیع احتمال مشخصی، تعیین شود. با افزایش تعداد نمونههای بدست آمده از این روش، نمودار هیستوگرام (Histogram) نقاط به توزیع اصلی شبیهتر میشود.
توزیع احتمالها در شکل زیر را در نظر بگیرید. با نمونهبرداری، انتظار داریم که نمونهها بیشتر در نواحی با احتمال بالاتر، تجمع کنند. اگر نمونهبرداری بدون محدودیت ادامه پیدا کند، انتظار میرود که تمام محدوده مورد نظر پوشش داده شود و متناسب به احتمال هر ناحیه، نقاط تجمع کنند. هیستوگرام نقاط نمونهبرداری شده نیز تابع توزیع احتمال را با دقت خوبی تقریب بزند. هر چه نمونهها بیشتر، تقریب دقیقتر و بهتر.
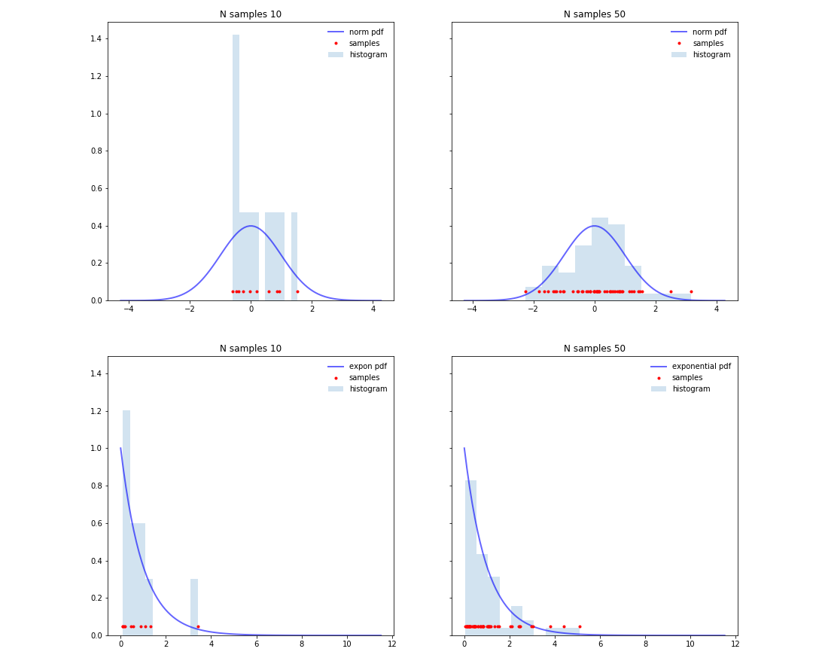
شکل 1- بالا: نمونههایی از توزیع نرمال. پایین: نمونههایی از توزیع نمایی. چپ: 10 نمونه. راست: 50 نمونه. نقاط نمونه هم با رنگ قرمز مشخص شده است.
نمونهبرداری از توزیع احتمال چندین کاربرد دارد. یکی از آنها، تست فرضهای جایگزین است. وقتی میخواهیم مساله انتخاب مدل سادهتر برای تطبیق به داده تولید شده در یک آزمایش را نسبت به مدل دیگر بررسی کنیم، سراغ این روش میرویم. اغلب اوقات، فرض جایگزین قابل فرمول کردن به شکل ریاضی و نمونهبرداری از آن به شکل استاندارد بوده و نتایج آن با اندازهگیری تجربی قابل مقایسه است. کاربرد دیگر زمانی است که توزیع احتمال، توزیع پسین (Posterior) پارامترهای یک مدل است و نمونهبرداری از آن، نمونههای مدل سازگار با داده را به ما ارائه میکند.
زمانیکه یک نمونه \( x_i \) از تابع چگالی احتمال داده شده \( p(x) \) را داشته باشیم، میتوانیم از آن برای تخمین مقادیر متوسط حاصل از تابع مشخصی مثل \( f(x) \) به شکل زیر استفاده کنیم:
$$ \int f(x) p(x) dx \approx \frac{1}{N} \sum_{i=1}^{N}f(x_i) $$
برای نمونه، تخمین مقدار میانگین توزیع از نمونهها، عبارت است از:
$$ \mu = \int x p(x) dx \approx \frac{1}{N} \sum_{i=1}^{N}x_i $$
در اینجا میخواهیم نشان دهیم که میتوان نمونههای حاصل از هر تابع توزیع احتمال دلخواه را تنها با استفاده از نمونههای حاصل از متغیر تصادفی با توزیع یکنواخت، بدست آورد.
این یک نتیجه مهم است زیرا اگرچه مثلا پایتون (Python) از طریق ماژول scypy.stats، توابع متنوعی برای تولید نمونهها از اکثر توزیعهای احتمال استاندارد فراهم میکند ولی در برخی موارد کمکی نخواهد کرد. مثلا برای حالتی که شما توزیع احتمال بدست آمده از یک آزمایش که برای آن فرم بسته تحلیلی و ریاضی قابل تصور نیست، در اختیار داشته باشید.
برای یک متغیر تصادفی \( X \)، تابع چگالی احتمال (Probability Density Function – PDF) به شکل زیر تعریف میشود:
$$ P(X=x)=p(x) $$
و تابع توزیع تجمعی (Cumulative Distribution Function – CDF) به صورت:
$$ F_X(x)=P(X \le x) = \int_{y \le x} p(y) dy $$
تابع CDF دارای خواص زیر است:
$$ \lim_{x \to – \infty} F_X(x)=0 $$
$$ \lim_{x \to + \infty} F_X(x)=1 $$
تابع \( F_X(x) \) به صورت صعودی است: \( x \le y \rightarrow F_X(x) \le F_X(y) \). اکثر توزیعهای پیوسته به طور اکید صعودی هستند اما همیشه چنین نیست و ممکن است در برخی توزیعها داشته باشیم: \( x <y \rightarrow F_X() =F_X(y) \)
به لحاظ هندسی، \( F_X(x) \) مساحت زیر منحنی \( P(X) \) تا نقطه \( x \) است (شکل 2). همچنین میتوان مشاهده کرد که:
$$ P(a \le x \le b)=F_X(b) – F_X(a) $$
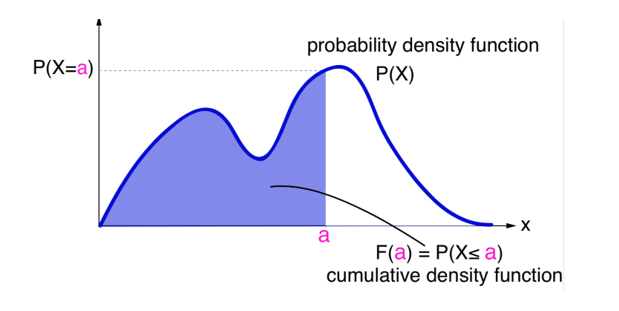
شکل 2- رابطه بین تابع چگالی احتمال، PDF و تابع توزیع تجمعی، CDF.
توزیع یکنواخت
میخواهیم در این بخش، خواص تابع توزیع یکنواخت را بررسی کنیم. تابع PDF یک متغیر تصادفی با توزیع یکنواخت \( U(a,b) \) روی بازه \( [a,b] \) به شکل زیر است:
$$ P(U=x)=\begin{cases} 0 \ \ \ \ x<a \\ \\ \frac{1}{b-a} \ \ \ \ \ a\le x \le b \\ \\ 0 \ \ \ \ \ \ x>b \end{cases} $$
و تابع CDF آن به شکل زیر:
$$ F_U(x)=P(U \le x)=\int_{-\infty}^{x}P(U=y)dy \\ \\ =\begin{cases} 0 \ \ \ \ x<a \\ \\ \frac{x-a}{b-a} \ \ \ \ \ a\le x \le b \\ \\ 1 \ \ \ \ \ \ x>b \end{cases} $$
در حالت خاص توزیع یکنواخت روی بازه \( [0,1] \)، تابع توزیع به فرم زیر در میآید:
$$ F_U(x)=\begin{cases} 0 \ \ \ \ x<0 \\ \\ x \ \ \ \ \ 0\le x \le 1 \\ \\ 1 \ \ \ \ \ \ x>1 \end{cases} $$
شکل زیر توزیع یکنواخت را برای دو حالت مختلف نشان میدهد.
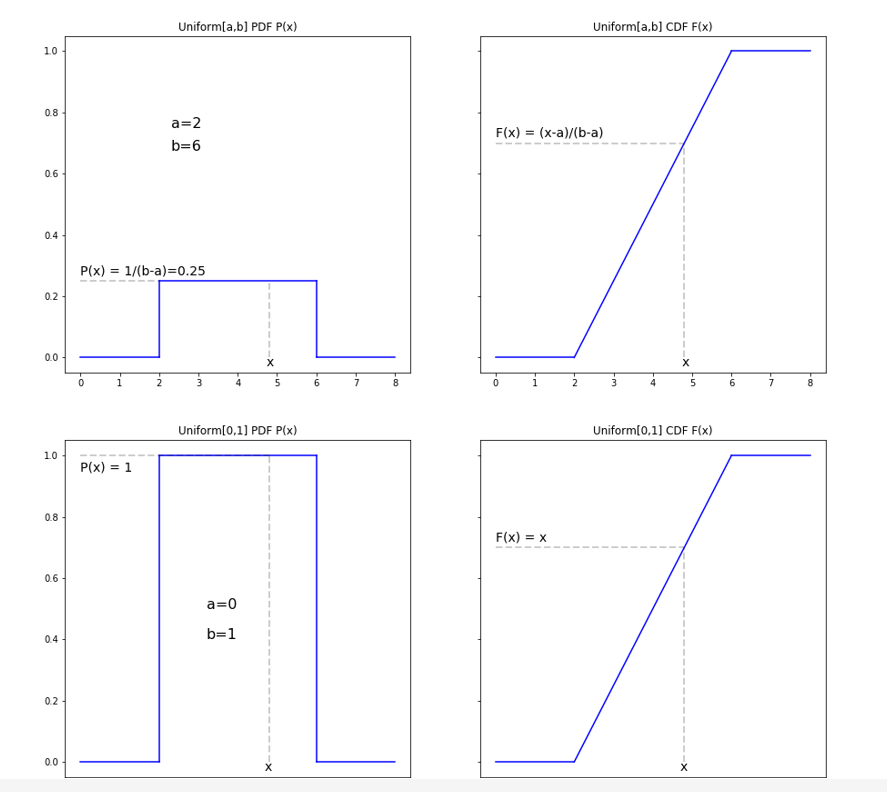
شکل 3- توزیع یکنواخت. چپ: تابع چگالی احتمال. راست: تابع توزیع تجمعی
اگر یک عدد \( r \in [0,1] \) با استفاده از مولد عدد تصادفی با توزیع یکنواخت تولید کنیم، داریم:
$$ F_U(r) = P(U \le r) = r $$
به طور خاص، چون برای هر نوع CDF، تابع \( F_X(X) \) مقادیر بین \( [0,1] \) را خواهد داشت:
$$ P(U \le F_X(x)) = F_X(x) $$
این نتیجه به ظاهر ساده، هسته اصلی روش تبدیل معکوس برای نمونهبرداری تابع توزیع احتمال است که در بخش بعد بررسی میشود.
تابع \( F_X(X) \) توزیع یکنواخت دارد
برای هر متغیر تصادفی \( X \) که دارای توزیع \( P(X) \) است (\( F_X(x) = P(X \le x) \))، میتوان نشان داد که تابع \( F_X(X) \) دارای توزیع یکنواخت در بازه \( [0,1] \) است.
این بدین معنی است که اگر \( x_1, x_2, \ldots, x_N \) یک سری نمونه از توزیع احتمال \( F_X \) باشند، آنگاه نمونههای تبدیل شده با تابع \( u_i = F_X(x_i) \) از توزیع یکنواخت پیروی میکنند:
$$ u1, \ldots, u_N $$
در راستای اثبات همین موضوع، نتیجه کد پایتون زیر در شکل 4 نشان داده شده است.
\(\)
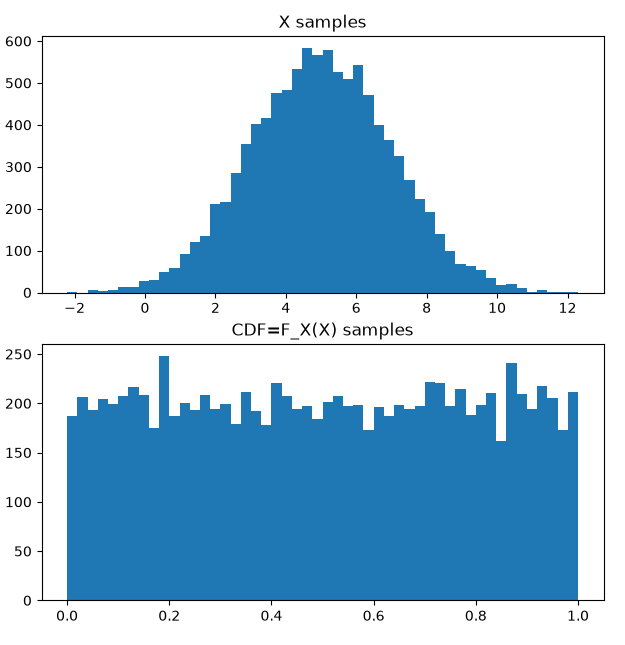
شکل 4- بالا: هیستوگرام متغیر تصادفی \(X \) با توزیع نرمال. پایین: هیستوگرام متغیر تصادفی \( F_X(X) \) که به شکل یکنواخت است.
روش تبدیل معکوس برای نمونهبرداری
بوسیله این روش میتوان از هر توزیع احتمال دلخواه به کمک مولد اعداد تصادفی با توزیع یکنواخت در بازه \( [0,1] \)، نمونهبرداری کرد.
روش تبدیل معکوس تنها به نمونه \( r \) حاصل از توزیع یکنواخت در بازه \( [0,1] \) نیاز دارد تا نمونه \( x=F_X^{-1}(r) \) را به عنوان مقدار نمونهبرداری شده، معرفی کند. در عمل این روش به تابع توزیع تجمعی نیاز دارد.
مراحل کار به شرح زیر است:
- یک مقدار تصادفی با توزیع یکنواخت در بازه \( [0,1] \) ایجاد کنید.
- یک خطی افقی در این مقدار بر روی تابع CDF رسم کنید.
- مقدار متناظر روی محور افقی را به عنوان نمونه حاصل معرفی کنید.
شکل زیر این فرآیند را نشان میدهد:
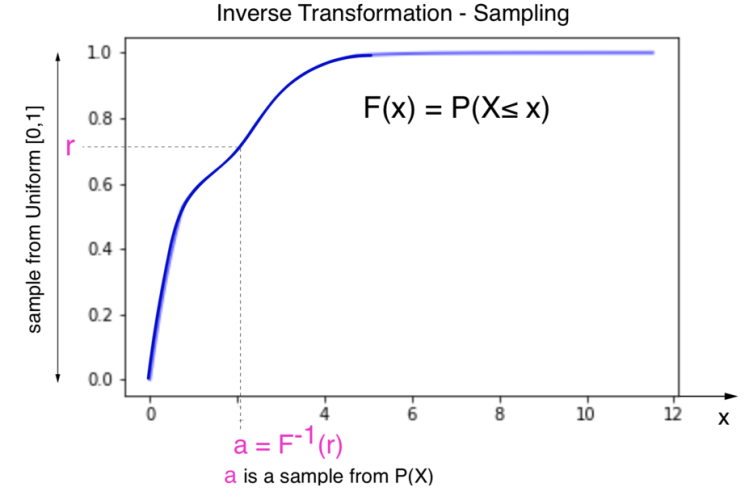
شکل 5- نمایش گرافیکی روش نمونهبرداری تبدیل معکوس
دقت کنید که در این روش باید تابع CDF معکوسپذیر باشد که به معنی اکید یکنوا بودن آن است.
حال میخواهیم نشان دهیم که نمونه حاصل از این روش دارای توزیع احتمال مورد نظر است، به عبارت دیگر، مقدار \( x=F_X^{-1}(r) \) در عبارت \( F_X(x)=P(X \le x) \) صدق میکند:
متغیر تصادفی \( A=F_X^{-1}(U) \) را در نظر بگیرید. باید نشان دهیم که \( A=X \).
$$ F_A(x)=P(A \le x)=P(F_X^{-1}(U) \le x) $$
چون \( F_X^{-1}(U)=X \) آنگاه، \( U=F_X(X) \)، در نتیجه:
$$ P(A \le x)=P(F_X^{-1}(U) \le x)=P(U \le F_X(x))=F_X(x) $$
که در نهایت ثابت میکند که \( A=X \).
مثال: نمونهبرداری از یک توزیع نمایی
توزیع نمایی، یکی از موارد محدودی است که در آن تابع معکوس توزیع احتمال به شکل عبارت تحلیل وجود دارد. توزیع نمایی، معرف فرآیندهایی است که به صورت تصادفی در طول زمان با نرخ ثابت \( \lambda \)، رخ میدهند. توزیع نمایی به طور گسترده در بیولوژی برای توصیف فرآیندهای زوال یا انحطاط همچون RNA یا تنزل پروتئین، استفاده میشود.
تابع PDF توزیع نمایی به شکل زیر است:
$$ P(E=x)=\lambda e^{-\lambda x} $$
که \( \lambda > 0 \) ، پارامتر دلخواه است و محدوده \( x \) برابر با \( [0, \infty ) \) است.
تابع CDF به طور تحلیلی به شکل زیر قابل محاسبه است:
$$ F_E(x)=\int_{-\infty}^{x}\lambda e^{-\lambda y}dy \\ \\ =-e^{-\lambda y} \Big|_{\infty}^x+1=1-e^{-\lambda x} $$
برای یک مقدار مشخص \( r_i \) که به طور یکنواخت از بازه \( [0,1] \) نمونهبرداری شده است، یک نمونه تصادفی \( x_i \) که از توزیع نمایی نمونهبرداری شده است، با استفاده از عبارت زیر بدست میآید:
$$ r_i=1-e^{-\lambda x_i} $$
$$ 1-r_i = e^{-\lambda x_i} $$
$$ log(1-r_i)=-\lambda x_i $$
در نهایت:
$$ x_i=-\frac{1}{\lambda}log(1-r_i)=F_E^{-1}(r_i) $$
به طور خلاصه، نمونهبرداری از توزیع نمایی با استفاده از نمونه \( r_i \) که از توزیع یکنواخت انتخاب شده است منجر به رابطه زیر میشود:
$$ x_i=-\frac{1}{\lambda}log(1-r_i) $$
دقت کنید که مقادیر نمونهبرداری شده مثبت هستند، زیرا:
$$ log(1-r)<0 \ \ \ if 0<r<1 $$
کد پایتون زیر، نمونهبرداری با روش بالا از توزیع نمایی را پیادهسازی میکند. در نهایت، نمودار تابع چگالی احتمالی آنالیزی یا تئوری در کنار هیستوگرام نمونههای تولید شده، رسم میشوند که صحت عملکرد این روش را تایید میکند.
\(\)
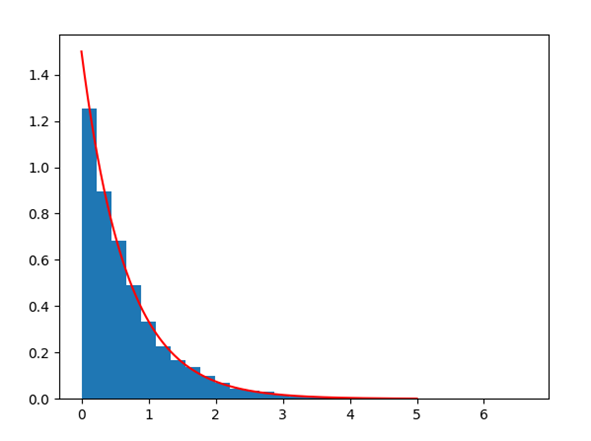
شکل 6- نمودار شبیهسازی روش تبدیل معکوس با پایتون
روشهای نمونهبرداری غیرمستقیم
روش نمونهبرداری تبدیل معکوس، به طور مستقیم از توزیع \( p(x) \) نمونهبرداری میکند. در برخی موارد، \( p(x) \) در دسترس نیست و در این شرایط، الگوریتمهای متعددی برای نمونهبرداری طراحی شدهاند.
نمونهبرداری مردودسازی (Rejection)
نمونهبرداری از توزیع احتمال \( p(x) \)، معادل نمونهبرداری یکنواخت از مساحت زیر منحنی آن است. در نمونهبرداری مردودسازی، مساحت زیر منحنی تابع دیگری، مثلا \( q(x) \)، با شرط \( p(x) \le M * q(x) \)، نمونهبرداری میشود.
برای تولید نمونهای از \( p(x) \)، داریم:
- \( x_i \) را در \( q(x) \) نمونهبرداری کنید.
- نمونه \( r \) از بازه \( [0,1] \) به طور یکنواخت انتخاب شود.
- آنگاه، اگر \( r<\frac{p(x_i)}{M*q(x_i)} \)، نمونه \( x_i \) پذیرفته است و در غیر این صورت، نمونه \( x_i \) مردود میشود.
در نواحی که \( p(x) \) مقدار زیادی دارد، احتمال مردود کردن نمونه \( x \) کمتر است و مقادیر بیشتری در آن نواحی بدست خواهد آمد. در صورت وجود قلهها و نواحی دره مانند در شکل توزیع، فرآیند مردودسازی بسیار زمانبر خواهد بود.
نمونهبرداری اهمیت (Importance)
این روش زمانی استفاده میشود که نمونهبرداری از تابع چگالی احتمال داده شده \( p(x) \)، دشوار است اما یک تابع توزیع دیگر \( q(x) \) مرتبط با آن وجود دارد که به مراتب برای نمونهبرداری سادهتر است.
نمونهبرداری اهمیت، اجازه محاسبه مستقیم نمونههای \( p(x) \) را نمیدهد، اما برای محاسبه متوسطهای یک تابع دلخواه \( f(x) \) نسبت به چگالی \( p(x) \) قابل استفاده است.
$$ \langle f \rangle = \int f(x)p(x) dx $$
که از طریق تابع کمکی \( g(x) \) به شکل زیر بازنویسی میشود:
$$ \begin{aligned} \langle f \rangle _p = \int f(x)p(x) dx \\ \\ = \int f(x) \frac{p(x)}{g(x)} g(x) dx = \int f(x) w(x) g(x) dx \\ \\ = \langle f * w \rangle _g \end{aligned}$$
که وزنها به شکل \( w(x) = \frac{p(x)}{g(x)} \) تعریف میشوند.
مراحل انجام نمونهبرداری به شرح زیر است:
- \( N \) نمونه از \( g(x) \) به شکل \( {x_i} \) گرفته میشود.
- وزنهای \( w(x_i) = \frac{p(x_i)}{g(x_i)} \) محاسبه میشوند.
- مقدار \( \langle f \rangle \approx \frac{1}{N}\sum_i f(x_i) w(x_i) \) تخمین زده میشود.
نمونهبرداری مونت کارلو (Monte Carlo)
نمونه برداری مونت کارلو، یک عبارت بسیار عمومی برای توصیف هر روشی است که اجازه تقریب یک توزیع احتمال \( p(x) \) را با گرفتن نمونههای \( {x_i} \) به صورتی میدهد که برای هر تابع \( f(x) \) از متغیر تصادفی قابل استفاده است:
$$ \int f(x)p(x) dx \approx \frac{1}{N} \sum_{i}^{N}f(x_i) $$
روشهای مختلفی (قواعد نمونهبرداری) برای تولید این نمونههای \( {x_i} \) که معرف \( p(x) \) هستند، قابل استفاده است.
نمونهبرداری مردودسازی و اهمیت، مثالهایی از نمونهبرداری مونت کارلو هستند. روش مشهور دیگر، مونت کارلو زنجیره مارکوف (Markov Chain Monte Carlo- MCMC) است که قاعده نمونهبرداری، یک فرآیند مارکوف (Markov Process) است (فرآیندی که تنها به مقدار نمونهبرداری شده قبلی، وابسته است).
منبع: http://mcb111.org